
Вопросы на собеседованиях
Вопросы на собеседованиях - БД
1) Назовите основные свойства транзакций
Тема называется — Stream API, но при этом вопрос по транзакции. Хмм…
Для начала давайте разберемся, что такое транзакция.
Транзакция — это группа последовательных операций с базой данных, которая представляет собой логическую единицу работы с данными.
Транзакция может быть выполнена либо целиком и успешно, соблюдая целостность данных и независимо от параллельно идущих других транзакций, либо не выполнена вообще, и тогда она не оказывает никакого эффекта.
Итак, у транзакций есть четыре основные свойства, которые сокращенно называют ACID.
Давайте разберем, как расшифровывается каждая буква данного сокращения:
A — Atomicity — атомарность — данное свойство гарантирует, что никакая транзакция не будет зафиксирована в системе частично. Будут либо выполнены все её подоперации, либо не выполнено ни одной (всё либо ничего).
С — Consistency — согласованность — свойство, гарантирующее, что каждая успешная транзакция зафиксирует только допустимые результаты. То есть, это гарантия того, что при успешной транзакции будут выполнены все правила, ограничения которые предъявляет система к конкретным данным, иначе транзакция не будет выполнена и данные в системе вернутся к прежнему состоянию.
I — Isolation — изолированность — свойство, которое говорит о том, что во время выполнения транзакции параллельные транзакции не должны оказывать влияния на ее результат. Это свойство ресурсозатратно, поэтому как правило оно выполняется частично, допуская определенные уровни изоляций, которые решают определенные изоляционные проблемы. Подробнее мы это обсудим в следующем вопросе.
D — Durability — стойкость — данное свойство гарантирует, что если пользователь получил подтверждение от системы, что транзакция выполнена, он может быть уверен, что сделанные им изменения не отменятся из-за какого-либо сбоя. То есть, вы можете быть уверены, что какой-нибудь сбой операционной системы ничего не сделает с вашими данными, если вы уже получили подтверждение успешного выполнения вашей транзакции.
2) Какие есть уровни изоляции транзакций?
Как я сказал ранее, обеспечение пункта ACID изолированности — ресурсозатратный процесс. Поэтому, это свойство выполняется частично. Есть различные уровни изолированности, и чем этот уровень выше, тем это более сильный удар по производительности.
Перед тем как перейти к уровням изоляций транзакций, нам нужно рассмотреть различные проблемы недостаточной изолированности транзакций:
фантомное чтение — при повторном вызове одной и той же выборки (одного и того же запроса) в рамках одной транзакции полученные данные различаются, что происходит из-за вставок данных другой транзакцией;
неповторяющееся чтение — при повторном вызове одной и той же выборки (одного и того же запроса) в рамках одной транзакции полученные данные различаются, что происходит из-за изменений (update) и удалений данных другой транзакцией;
грязное чтение — процесс чтения данных, добавленных или измененных транзакцией, которая впоследствии не подтвердится (откатится), т.е. чтение недействительных данных;
потерянное обновление — при одновременном изменении одних и тех же данных разными транзакциями теряются все изменения, кроме последнего (напоминает проблему “состояние гонки” в многопоточной среде).
Уровни изоляций транзакций как раз и характерезуются тем, от каких проблем изолированности они защищают.
Рассмотрим в виде таблицы уровни изоляций и то, от каких проблем они защищают: |Уровень изоляции|Фантомное чтение|Неповторяющееся чтение|Грязное чтение|Потерянное обновление| |-|-|-|-|-| |SERIALIZABLE|+|+|+|+| |REPEATABLE READ|-|+|+|+| |READ COMMITTED|-|-|+|+| |READ UNCOMMITTED|-|-|-|+| |NONE|-|-|-|-|
И не забывайте обратную сторону медали: чем больший будет уровень изоляции, тем дольше будут отрабатывать транзакции (при параллельном выполнении нескольких транзакций).
3) Какая разница между Statement и PreparedStatement?
И тут не сильно плавный переход на особенности технологии JDBC.
Итак, для начала давайте разберемся, что вообще такое Statement. Это объект, который используется для формирования SQL запросов.
В JDBC используется три его вида — Statement, PreparedStatement и CallableStatement.
CallableStatement мы сегодня рассматривать не будем: поговорим о различии между Statement и PreparedStatement.
Statementиспользуется для выполнения простых SQL запросов без входящих, динамически вставляемых параметров.PrepareStatementиспользуется с возможностью динамической вставки входных параметров.Для задания параметров в
PreparedStatementвходные параметры в запросе прописываются как знаки вопроса, чтобы вместо них потом вставить некоторое значение с помощью различных сеттеров, таких какsetDouble(),setFloat(),setInt(),setTime()…. В итоге вы не вставите в запрос данные не того типа.PreparedStatement“прекомпилирован” и использует кеширование, поэтому его исполнение может происходить немного быстрее, чем запрос из объектовStatement. В результате SQL запросы, которые исполняются часто, в целях улучшения производительности создают в виде объектовPreparedStatement.Statementуязвим к SQL инъекциям, в то время какPreparedStatementпредотвращает их.
Практические задачи
4) Matrix Diagonal Sum (задача с Leetcode)
Условие: Подсчитайте сумму всех элементов на основной диагонали и всех элементов на дополнительной диагонали, которые не являются частью основной диагонали.
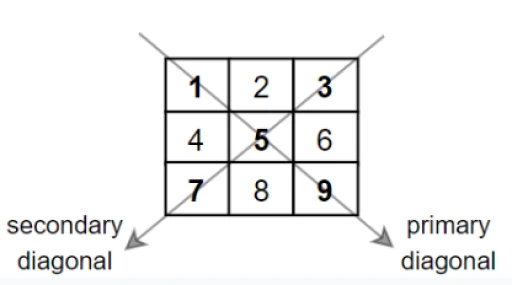
- При матрице вида :
mat = [[1,2,3],
      [4,5,6],
      [7,8,9]]
Вывод должен быть — 25
- При матрице -
mat = [[1,1,1,1],
      [1,1,1,1],
      [1,1,1,1],
      [1,1,1,1]]
Вывод должен быть — 8
- При матрице -
mat = [[5]]Вывод должен быть — 5
Сделайте паузу в прочтении и реализуйте своё решение.
Мое же решение будет следующим:
public static int countDiagonalSum(int[][] matrix) {
 int sum = 0;
 for (int i = 0, j = matrix.length - 1; i < matrix.length; i++, j--) {
   sum += matrix[i][i];
   if (j != i) {
     sum += matrix[i][j];
   }
 }
 return sum;
}
Всё происходит с помощью одного прохода по массиву, во время которого у нас есть два индекса для отчёта: i — для отчёта строк массива и колонок основной диагонали, j — для отчёта колонок дополнительной диагонали.
Если же ячейка основной диагонали и дополнительной совпадают, то одно из значений игнорируется при подсчете суммы.
Проверим, используя матрицы из условия:
int[][] arr1 = {
   {1, 2, 3},
   {4, 5, 6},
   {7, 8, 9}};
System.out.println(countDiagonalSum(arr1));

int[][] arr2 = {
   {1, 1, 1, 1},
   {1, 1, 1, 1},
   {1, 1, 1, 1},
   {1, 1, 1, 1}};
System.out.println(countDiagonalSum(arr2));

int[][] arr3 = {{5}};
System.out.println(countDiagonalSum(arr3));
Вывод в консоли:
25
8
5
5) Move Zeroes (задача с Leetcode)
Условие: В целочисленном массиве переместите все 0 в конец, сохраняя относительный порядок ненулевых элементов.
При массиве:
[0,1,0,3,12]Вывод должен быть:[1,3,12,0,0]При массиве:
[0]Вывод должен быть:[0]
Сделайте паузу и напишите свое решение
...
Моё решение:
public static void moveZeroes(int[] nums) {
 int counterWithoutNulls = 0;
 int counterWithNulls = 0;
 int length = nums.length;
 while (counterWithNulls < length) {
   if (nums[counterWithNulls] == 0) {// находим нулевые элементы и увеличиваем счётчик
     counterWithNulls++;
   } else { // сдвигаем элементы на количество найденных нулевых элементов слева
     nums[counterWithoutNulls++] = nums[counterWithNulls++];
   }
 }
 while (counterWithoutNulls < length) {
   nums[counterWithoutNulls++] = 0;// заполняем последние элементы массива нулями согласно счётчику нулей
 }
}
Проверка:
int[] arr1 = {1, 2, 0, 0, 12, 9};
moveZeroes(arr1);
System.out.println(Arrays.toString(arr1));

int[] arr2 = {0};
moveZeroes(arr2);
System.out.println(Arrays.toString(arr2));
Вывод в консоль:
[1, 2, 12, 9, 0, 0]
[0]
6) Given List <String> names. Удалите первую букву из каждого имени и поверните отсортированный список
- Первое, что приходит в голову, это методы класса
Collections, хранящий в себе множество вспомогательных методов для коллекций:
public static List<String> processTheList(List<String> nameList) {
 for (int i = 0; i < nameList.size(); i++) {
   nameList.set(i, nameList.get(i).substring(1));
 }
 Collections.sort(nameList);
 return nameList;
}- Также если мы используем Java версии 8 и выше мы просто обязаны показать решение через стримы:
public static List<String> processTheList(List<String> nameList) {
 return nameList.stream()
     .map(x -> x.substring(1))
     .sorted().collect(Collectors.toList());
}
Независимо от выбранного решения, проверка может быть следующая:
List<String> nameList = new ArrayList();
nameList.add("John");
nameList.add("Bob");
nameList.add("Anna");
nameList.add("Dmitriy");
nameList.add("Peter");
nameList.add("David");
nameList.add("Igor");

System.out.println(processTheList(nameList));
Вывод в консоли:
[avid, eter, gor, mitriy, nna, ob, ohn]7) Переверните массив
Решение 1
Опять же, первое, что приходит в голову — использовать методы вспомогательного, утилитного класса Collections. Но так как у нас массив, сперва нужно преобразовать его в коллекцию (список):
public static Integer[] reverse(Integer[] arr) {
 List<Integer> list = Arrays.asList(arr);
 Collections.reverse(list);
 return list.toArray(arr);
}
Решение 2 Так как вопрос был про массив, думаю, необходимо показать решение и без использования готового функционала из коробки, а так сказать, по классике:
public static Integer[] reverse(Integer[] arr) {
for (int i = 0; i < arr.length / 2; i++) {
  int temp = arr[i];
  arr[i] = arr[arr.length - 1 - i];
  arr[arr.length - 1 - i] = temp;
}
return arr;
}
Проверка:
Integer[] arr = {1, 2, 3, 4, 5, 6, 7, 8, 9};
System.out.println(Arrays.toString(reverse(arr)));
Вывод в консоли:
[9, 8, 7, 6, 5, 4, 3, 2, 1]8) Проверить, является ли строка палиндромом
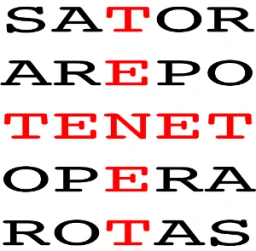
Решение 1
Стоит сразу вспомнить о StringBuilder: он более гибкий и насыщенный различными методами по сравнению с обычным String. Нас особенно интересует метод reverse:
public static boolean isPalindrome(String string) {
 string = string.toLowerCase(); //приводит всю строку к нижнему регистру
 StringBuilder builder = new StringBuilder();
 builder.append(string);
 builder.reverse(); // перевочиваем строку методом Builder-а
 return (builder.toString()).equals(string);
}
Решение: Следующий подход будет без использования “лазеек” из коробки. Сравниваем символы из задней части строки с соответствующими символами из передней:
public static boolean isPalindrome(String string) {
 string = string.toLowerCase();
int length = string.length();
int fromBeginning = 0;
int fromEnd = length - 1;
while (fromEnd > fromBeginning) {
  char forwardChar = string.charAt(fromBeginning++);
  char backwardChar = string.charAt(fromEnd--);
  if (forwardChar != backwardChar)
    return false;
}
return true;
}
И проверяем оба подхода:
boolean isPalindrome = isPalindrome("Tenet");
System.out.println(isPalindrome);
Вывод в консоли:
true9) Написать простой алгоритм сортировки (Bubble, Selection или Shuttle). Как его можно улучшить?
В качестве просто алгоритма для реализации я выбрал сортировку выбором — Selection Sort:
public static void selectionSorting(int[] arr) {
for (int i = 0; i < arr.length - 1; i++) {
  int min = i;
  for (int j = i + 1; j < arr.length; j++) {
    if (arr[j] < arr[min]) {
      min = j; // выбираем минимальный элемент в текущем числовом отрезке
    }
  }
  int temp = arr[min]; // меняем местами минимальный элемент с элементом под индексом i
  arr[min] = arr[i]; // так как отрезок постоянно уменьшается
  arr[i] = temp; // и выпадающие из него числа будут минимальными в текущем отрезке
} // и как итог - числа оставшиеся вне текущей итерации отсортированы от самого наименьшего к большему
}
Улучшенный вариант будет выглядеть следующим образом:
public static void improvedSelectionSorting(int[] arr) {
for (int i = 0, j = arr.length - 1; i < j; i++, j--) { // рассматриваемый отрезок с каждой итерацией
  // будет уменьшаться с ДВУХ сторон по одному элементу
  int min = arr[i];
  int max = arr[i];
  int minIndex = i;
  int maxIndex = i;
  for (int n = i; n <= j; n++) { // выбираем min и max на текущем отрезке
    if (arr[n] > max) {
      max = arr[n];
      maxIndex = n;
    } else if (arr[n] < min) {
      min = arr[n];
      minIndex = n;
    }
  }
  // меняем найденный минимальный элемент с позиции с индексом min на позицию с индексом i
  swap(arr, i, minIndex);

  if (arr[minIndex] == max) {// срабатывает, если элемент max оказался смещен предыдущей перестановкой -
    swap(arr, j, minIndex); // на старое место min, поэтому с позиции с индексом min смещаем его на позицию j
  } else {
    swap(arr, j, maxIndex); // простое обмен местами элементов с индексами max и j
  }
}
}

static int[] swap(int[] arr, int i, int j) {
int temp = arr[i];
arr[i] = arr[j];
arr[j] = temp;
return arr;
}
Ну а теперь нам нужно убедиться, правда ли сортировка улучшилась.
Давайте сравним производительность:
long firstDifference = 0;
long secondDifference = 0;
long primaryTime;
int countOfApplying = 10000;
for (int i = 0; i < countOfApplying; i++) {
 int[] arr1 = {234, 33, 123, 4, 5342, 76, 3, 65,
     3, 5, 35, 75, 255, 4, 46, 48, 4658, 44, 22,
     678, 324, 66, 151, 268, 433, 76, 372, 45, 13,
     9484, 499959, 567, 774, 473, 3, 32, 865, 67, 43,
     63, 332, 24, 1};
 primaryTime = System.nanoTime();
 selectionSorting(arr1);
 firstDifference += System.nanoTime() - primaryTime;

 int[] arr2 = {234, 33, 123, 4, 5342, 76, 3, 65,
     3, 5, 35, 75, 255, 4, 46, 48, 4658, 44, 22,
     678, 324, 66, 151, 268, 433, 76, 372, 45, 13,
     9484, 499959, 567, 774, 473, 3, 32, 865, 67, 43,
     63, 332, 24, 1};
 primaryTime = System.nanoTime();
 improvedSelectionSorting(arr2);
 secondDifference += System.nanoTime() - primaryTime;
}

System.out.println(((double) firstDifference / (double) secondDifference - 1) * 100 + "%");
Обе сортировки запустились в одном и том же цикле, т.к. если бы были отдельные циклы, сортировка из в коде выше показывала бы худший результат, нежели если её поставить второй.
Это связано с тем, что программа как бы “разогревается” и дальше работает немного быстрее.
Но я немного отошёл от темы.
После пяти запусков данной проверки в консоли я увидел увеличение производительности на:
36.41006735635892%
51.46131097160771%
41.88918834013988%
48.091980705743566%
37.120220461591444%
Как по мне, это довольно-таки хороший результат.
10) Напишите алгоритм (последовательность действий) составления литерала типа int с литералом типа byte. Объясните, что происходит с памятью
byte значение приводится к int. Для него будет выделен не 1 байт памяти, а как и для всех int значений — 4, если этого значения ещё нет в int стеке. Если же есть — просто будет получена ссылка на него.
Два int значения будут сложены и получится третье. Под него выделится новый участок памяти — 4 байта (либо будет получена ссылка из int стека на существующее значение).
При этом память двух int всё ещё будет занята, и их значения будут храниться в int стеке соответственно.
11) Какие нововведения анонсировано в Java 8?
Нововведения принесенные Java 8 следующие:
Добавлены функциональные интерфейсы, о том что это за зверь читайте тут.
Лямбда-выражения, которые тесно связаны с функциональными интерфейсами, подробнее об их использовании вот тут.
Добавлено Stream API для удобной обработки коллекций данных, подробнее читайте тут.
Добавлены ссылки на методы.
В Iterable интерфейс добавлен метод forEach().
Добавлен новый API даты и времени в пакете java.time, подробный разбор тут.
Улучшили Concurrent API.
Добавление класса обертки Optional, который используется для корректной обработки нулевых значений, отличную статью на данную тему вы найдете вот тут.
Добавление интерфейсам возможности использовать static и default методы (что, по сути, приближает Java к множественному наследованию), подробнее тут.
Добавили новые методы в класс Collection(removeIf(), spliterator()).
Мелкие улучшения Java Core.